
GPT Image 2 モデルで作成できるもの
イラスト、製品シーン、キャンペーンコンセプト、ポスター、ソーシャルグラフィック、ストーリーボード、ビジュアルドラフトなどに使用してください。プロンプトから開始し、画像参照を追加するか、既存のビジュアルを編集します。結果は単独で使用することも、ビデオ作成の開始フレームとして使用することもできます。
GPT Image 2 は、高忠実度の画像入力、高度なテキスト レンダリング、自然言語編集、最大 3,840 ピクセルの柔軟な出力をサポートしています。 GPT Image 2 の例と設定を調べる
モデル概要
GPT Image 2 は、高速で高品質の生成と編集を行うための OpenAI の現在の画像生成モデルです。テキストと画像の入力を受け入れ、柔軟な画像サイズをサポートし、参照画像を高忠実度で処理します。
イラスト、製品シーン、キャンペーンコンセプト、ポスター、ソーシャルグラフィック、ストーリーボード、ビジュアルドラフトなどに使用してください。プロンプトから開始し、画像参照を追加するか、既存のビジュアルを編集します。結果は単独で使用することも、ビデオ作成の開始フレームとして使用することもできます。
作成モード
接続されていないツール間の作業を中断することなく、最初のアイデアから使用可能なビジュアルに移行します。最初のバージョンを生成して検査し、有用な決定を保持しながら残りを調整します。
主題、設定、構成、照明、雰囲気、視覚的処理について説明します。明確な概要は、大まかなコンセプトをキャンペーン、製品アイデア、またはストーリーフレームの意図的な視覚的方向に変えるのに十分なコンテキストをモデルに提供します。
全体のイメージを再構築するのではなく、通常の言葉で焦点を絞った変更を依頼してください。別の背景、色処理、レイアウト、オブジェクト、または詳細をテストするときに、何を変更する必要があり、何を変更しない必要があるかを指定します。
言葉だけでは製品、キャラクター、構成、または視覚的な方向性を定義できない場合は、参照を追加します。 GPT Image 2 は画像入力を高忠実度で処理し、プロンプトでは何を保存、再解釈、または削除するかを説明します。
最初の出力をドラフトとして扱います。マルチターン画像ワークフローを使用すると、1 つの大規模なプロンプトではなく、短いフォローアップ指示を通じてフレーミングを改善したり、シーンを簡素化したり、詳細を修正したり、新しい治療法を検討したりすることができます。
クリエイティブコントロール
有用な画像は魅力的な結果以上のものです。適切な階層、繰り返される視覚的な詳細、およびすでに承認された決定を保護する改訂パスが必要です。
01
ポスター、表紙、メニュー、パッケージ、ソーシャル グラフィックのコンセプトを、言葉を構成要素として構築します。正確なコピー、配置、階層、および入力方向を指定し、公開する前にスペルと配置を確認します。 OpenAI は、正確なテキストのレンダリングにはまだ修正が必要な場合があると述べています。
02
キャラクター、製品、パレット、または雰囲気をガイドするために、関連する画像全体で同じ参照とクリエイティブなルールを伝えます。一貫性は可能ですが、繰り返し発生する詳細が世代間で変動する可能性があるため、各結果を承認された参照と比較してください。
03
イメージの大部分がすでに機能している場合は、リビジョンを分離します。保持したい構成や詳細を明示的に保護しながら、表現、オブジェクト、背景要素、照明の選択、またはコピーの行を変更します。
クリエイティブなワークフロー
視聴者が必要とする形式から始めて、メッセージに基づいて画像を形成し、最初から次の制作ステップが見えるようにします。
01
ソーシャルグラフィックスとマーケティングバナー
ブリーフに書き込まれた意図されたアスペクト比、焦点となる主題、見出しスペース、ブランドの雰囲気を使用して、ローンチ投稿、イベント グラフィック、有料広告のコンセプト、チャネル固有のレイアウトを調べます。
02
製品ビジュアルと e コマース クリエイティブ
最終的な写真撮影や制作に着手する前に、製品リファレンスを季節、ライフスタイル、または概念的なシーンに配置して、初期のキャンペーンの方向性を比較します。
03
コンセプトアートと絵コンテ
脚本、シーンの説明、またはキャラクターのメモをフレームに変換すると、共同作業者がアニメーションや撮影前に構成、トーン、不足しているストーリー ビートについて話し合うのに役立ちます。
04
GPT Image 2 画像をビデオに変換
選択した静止画を開始フレーム、スタイル参照、ストーリーボード パネル、またはキャンペーン アセットとして使用し、承認したビジュアル方向に沿ってモーションや追加のシーンを構築します。
4 ステップのワークフロー
複雑な式は必要ありません。目標を理解するのに十分なコンテキストをモデルに与え、その目標に照らして最初の結果を判断し、一度に 1 つずつ明確な修正を加えます。
主題、場面、目的、視覚的な扱いについて説明します。特定の人物、オブジェクト、製品、スタイル、または構成が結果を導く必要がある場合は、参照を追加します。
目的のチャンネルに合ったサイズと品質を選択してください。最初のバージョンを生成し、スタイルだけではなく、構成、メッセージ、階層、および詳細を評価します。
何を変えるべきか、何を残すべきかを述べます。背景の置き換え、コピーの修正、照明の調整、気が散る要素の 1 つの削除など、各フォローアップに焦点を当ててください。
ビジュアルをスタンドアロン アセットとしてダウンロードするか、リファレンス、ストーリーボード フレーム、キャンペーン コンセプト、または AI 生成ビデオの開始画像として継続します。
視覚的な例
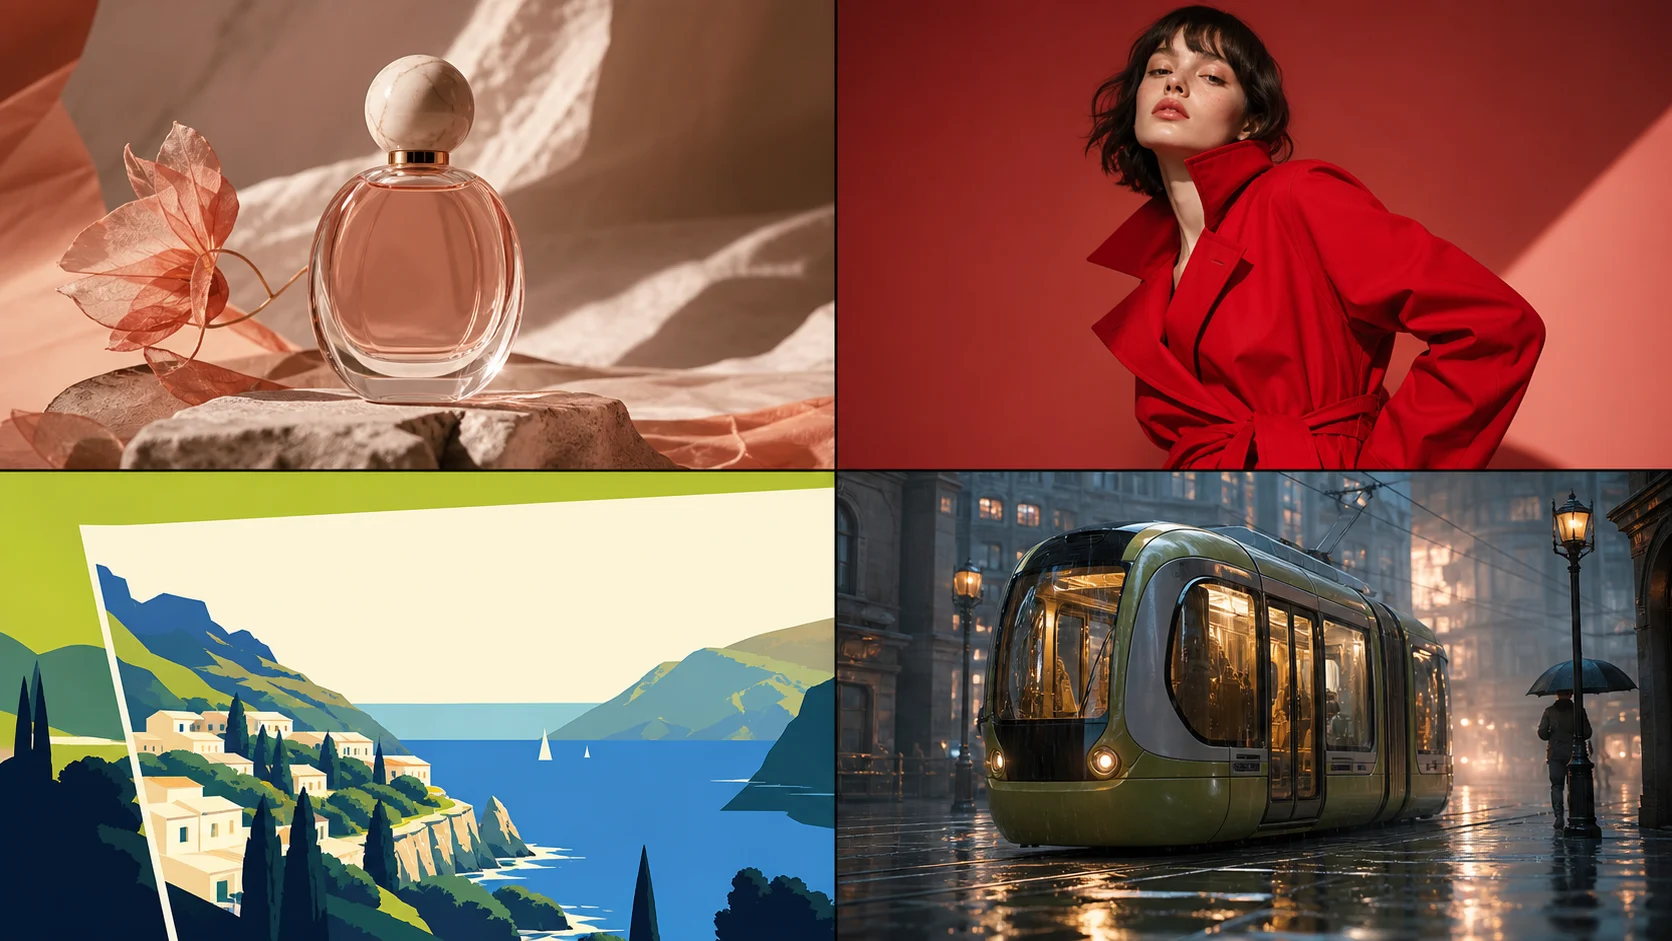
1 つのブリーフが、製品の写真、ファッションのエディトリアル、グラフィック イラスト、または映画のようなストーリーのフレームにつながる可能性があります。明瞭さ、構成、使いやすいディテール、最終チャンネルへの適合など、スタイル全体で同じレビュー基準を使用します。
プロンプトガイド
強力なプロンプトは、形容詞の山ではなく、意図と優先順位を伝えます。モデルに構造化された概要を与え、短いフォローアップを使用して個々の意思決定を調整します。
プロンプト 01
主題とアクションから始めます。設定、カメラの距離、視点、照明、雰囲気、重要な要素の意図した配置を追加します。コピーが被写体の上に配置される場合は、構図内にそのスペースを確保してください。
プロンプト 02
必要な文言を引用符で囲み、それが属する場所を明記します。見出しの階層、サポートコピー、タイプの扱い、色の方向、対象読者について説明します。重要なテキストは短くし、公に使用する前にすべての文字を検査してください。
プロンプト 03
編集ターゲット、要求された変更、および保護された詳細に名前を付けます。たとえば、背景のみを静かな夜の街並みに置き換えます。被写体、服装、ポーズ、トリミング、カメラアングルを変更しないでください。
機種比較
すべてのブリーフを勝ち取るイメージモデルは存在しません。同じプロンプト、参照、アスペクト比、および許容基準を使用してそれらを比較し、妥協が少なく使用可能な結果に達したものを保持します。
01
どちらもテキストと画像の作成ワークフローをサポートしています。 GPT Image 2 は、高忠実度の画像入力、生成、編集、会話の洗練を中心としています。 Google は、Nano Banana Pro を、複雑なグラフィック デザイン、製品モックアップ、正確なテキスト、現実の情報を反映した画像制作として位置付けています。選択する前に同じ概要をテストしてください。
02
作品を指示する方法を中心に選択してください。プロセスが会話編集と保護された詳細に依存する場合は、GPT Image 2 をテストします。画像、スタイル、キャラクター、またはオムニリファレンスが探索の中心となる場合は、Midjourney を比較してください。どちらの参照ワークフローも、正確なコピーを保証するものではありません。
03
OpenAI は、以前の非推奨のイメージ モデルとして GPT Image 1.5 をリストするようになりました。移行を評価するときに同じプロンプトと編集シーケンスを実行し、構成、参照の忠実度、修正の労力、出力サイズ、および新しいモデルが実際のワークフローを改善するかどうかを判断します。
一目でわかる
これらはワークフロー レベルの違いであり、品質のランク付けではありません。製品の表面、モデルのバージョン、出力オプション、および入手可能性は変更される可能性があります。制作を決定する前に、リンクされた一次ソースを開いてください。
GPT Image 2
Nano Banana Pro
旅の途中
GPT Image 1.5
OpenAI には、正確なテキストの配置、繰り返しの視覚的な一貫性、レイアウトに依存した構成に関する現在の制限も記載されています。最初の出力はすべて、レビューが必要な下書きとして扱います。
一次情報源
スターター クレジットから始める
次のアイデアを画像に変換し、焦点を絞った指示を通じて洗練させ、それがより広範なクリエイティブ ワークフローにどのように適合するかを確認します。新規ユーザーはサインアップ後にスターター クレジットを受け取ります。それ以降の使用は、現在の Open AI Image クレジット ルールに従います。
作成を始めるよくある質問
アクセス、生成、編集、プロンプト、価格設定、API サポート、および責任ある商用利用についての簡単な回答。
接続されたワークフロー
画像ワークフローの便利な部分は、最初の結果の後に何が起こるかです。承認された視覚的方向が引き継ぎ後も存続するように、生成、レビュー、反復、および動作計画を密接に保ちます。
01
制作前にアイデアを比較する
複数の指示を早期に生成し、同じ概要に照らして評価し、共同作業者が見て議論できる視覚的な決定を進めます。
02
編集中に承認された詳細を保護する
焦点を絞った改訂指示を使用して、承認を妨げている 1 つの詳細を変更しながら、主題、トリミング、パレット、または構成を保持します。
03
静止画像を動きに持ち込む
選択したコンセプトを、それを有用なものとした開始フレーム、ストーリービート、またはアートディレクションを失うことなく、画像からビデオへのワークフローやより広範な AI ビデオワークフローに移行します。
探索を続けてください
異なるブリーフには、異なるビジュアル エンジンとフォローアップ ツールの恩恵が受けられます。必要なワークフローを比較し、アイデアから使用可能な資産までの最短パスを選択します。
実践ガイド
これらのガイドを使用して、プロンプトを強化し、静止画像を動きに変換し、制作前に幅広い生成ワークフローを比較します。
関連機種
テキスト、最初のフレーム、またはマルチモーダル参照ワークフローをサポートするモデルを使用して、画像の作成からビデオの生成に進みます。
GPT Image 2 · 作成および編集
プロンプトまたは参照画像から始めて、一度に 1 つの決定を改良し、最も強力な結果を次のクリエイティブ アセットに変えます。
今すぐ始めましょう